
Co faktycznie wynoszą hakerzy z bazy danych?
Dane medyczne to nie „kolejna tabela w bazie”. Dwa wzorce, które ograniczają skutki wycieku
W ciągu kilku tygodni polska ochrona zdrowia przeżyła trzy poważne incydenty. Najpierw na jedną z wiodących platform do prowadzenia Elektronicznej Dokumentacji Medycznej, z której według UODO wyciekły dane ok. 19 mln Polaków (baza ok. 2,5 TB). W wycieku mogły się znaleźć m.in. imię i nazwisko, adres, PESEL, dane kontaktowe, dane o zdrowiu oraz informacje o lekach i receptach. Do połowy września do UODO trafiło ponad 2 tys. zgłoszeń od placówek korzystających z systemu.
Potem kolejny atak na podobny system – potencjalnie do 5 mln osób. A 24 września atak skierowany na jedno z centrów medycznych: napastnicy uzyskali dostęp do części infrastruktury i części danych pacjentów, według spółki ok. 3% całej bazy. Incydenty zostały oczywiście zgłoszone do CBZC, CERT Polska i UODO i zapowiedział indywidualny kontakt z poszkodowanymi.
Nie znamy szczegółów technicznych tych ataków i nie oceniamy ich. Jedna lekcja jest jednak uniwersalna: zakładaj, że kiedyś ktoś może dostać się do Twojej bazy. Pytanie architektoniczne brzmi więc nie tylko „jak nie wpuścić napastnika”, ale też „co on zobaczy, gdy już wejdzie”. Poniżej dwa wzorce, które stosujemy w projektach medycznych: blind index i rozdział danych medycznych od pozostałych.
Blind index: szukaj po pacjencie, nie przechowując go jawnie
Klasyczny problem: chcemy zaszyfrować lub spseudonimizować identyfikator pacjenta, ale nadal musimy szybko odpowiadać na pytanie „pokaż wszystkie wyniki tego pacjenta”. Szyfrowanie z losowym IV (np. AES-GCM) uniemożliwia szukanie po instrukcji WHERE, bo ta sama wartość za każdym razem daje inny szyfrogram.
Rozwiązanie to blind index – deterministyczny skrót liczony kluczem tajnym:blindIndex(value: string): string {
return createHmac('sha256', this.blindIndexKey)
.update(value.trim().toLowerCase())
.digest('hex');
}
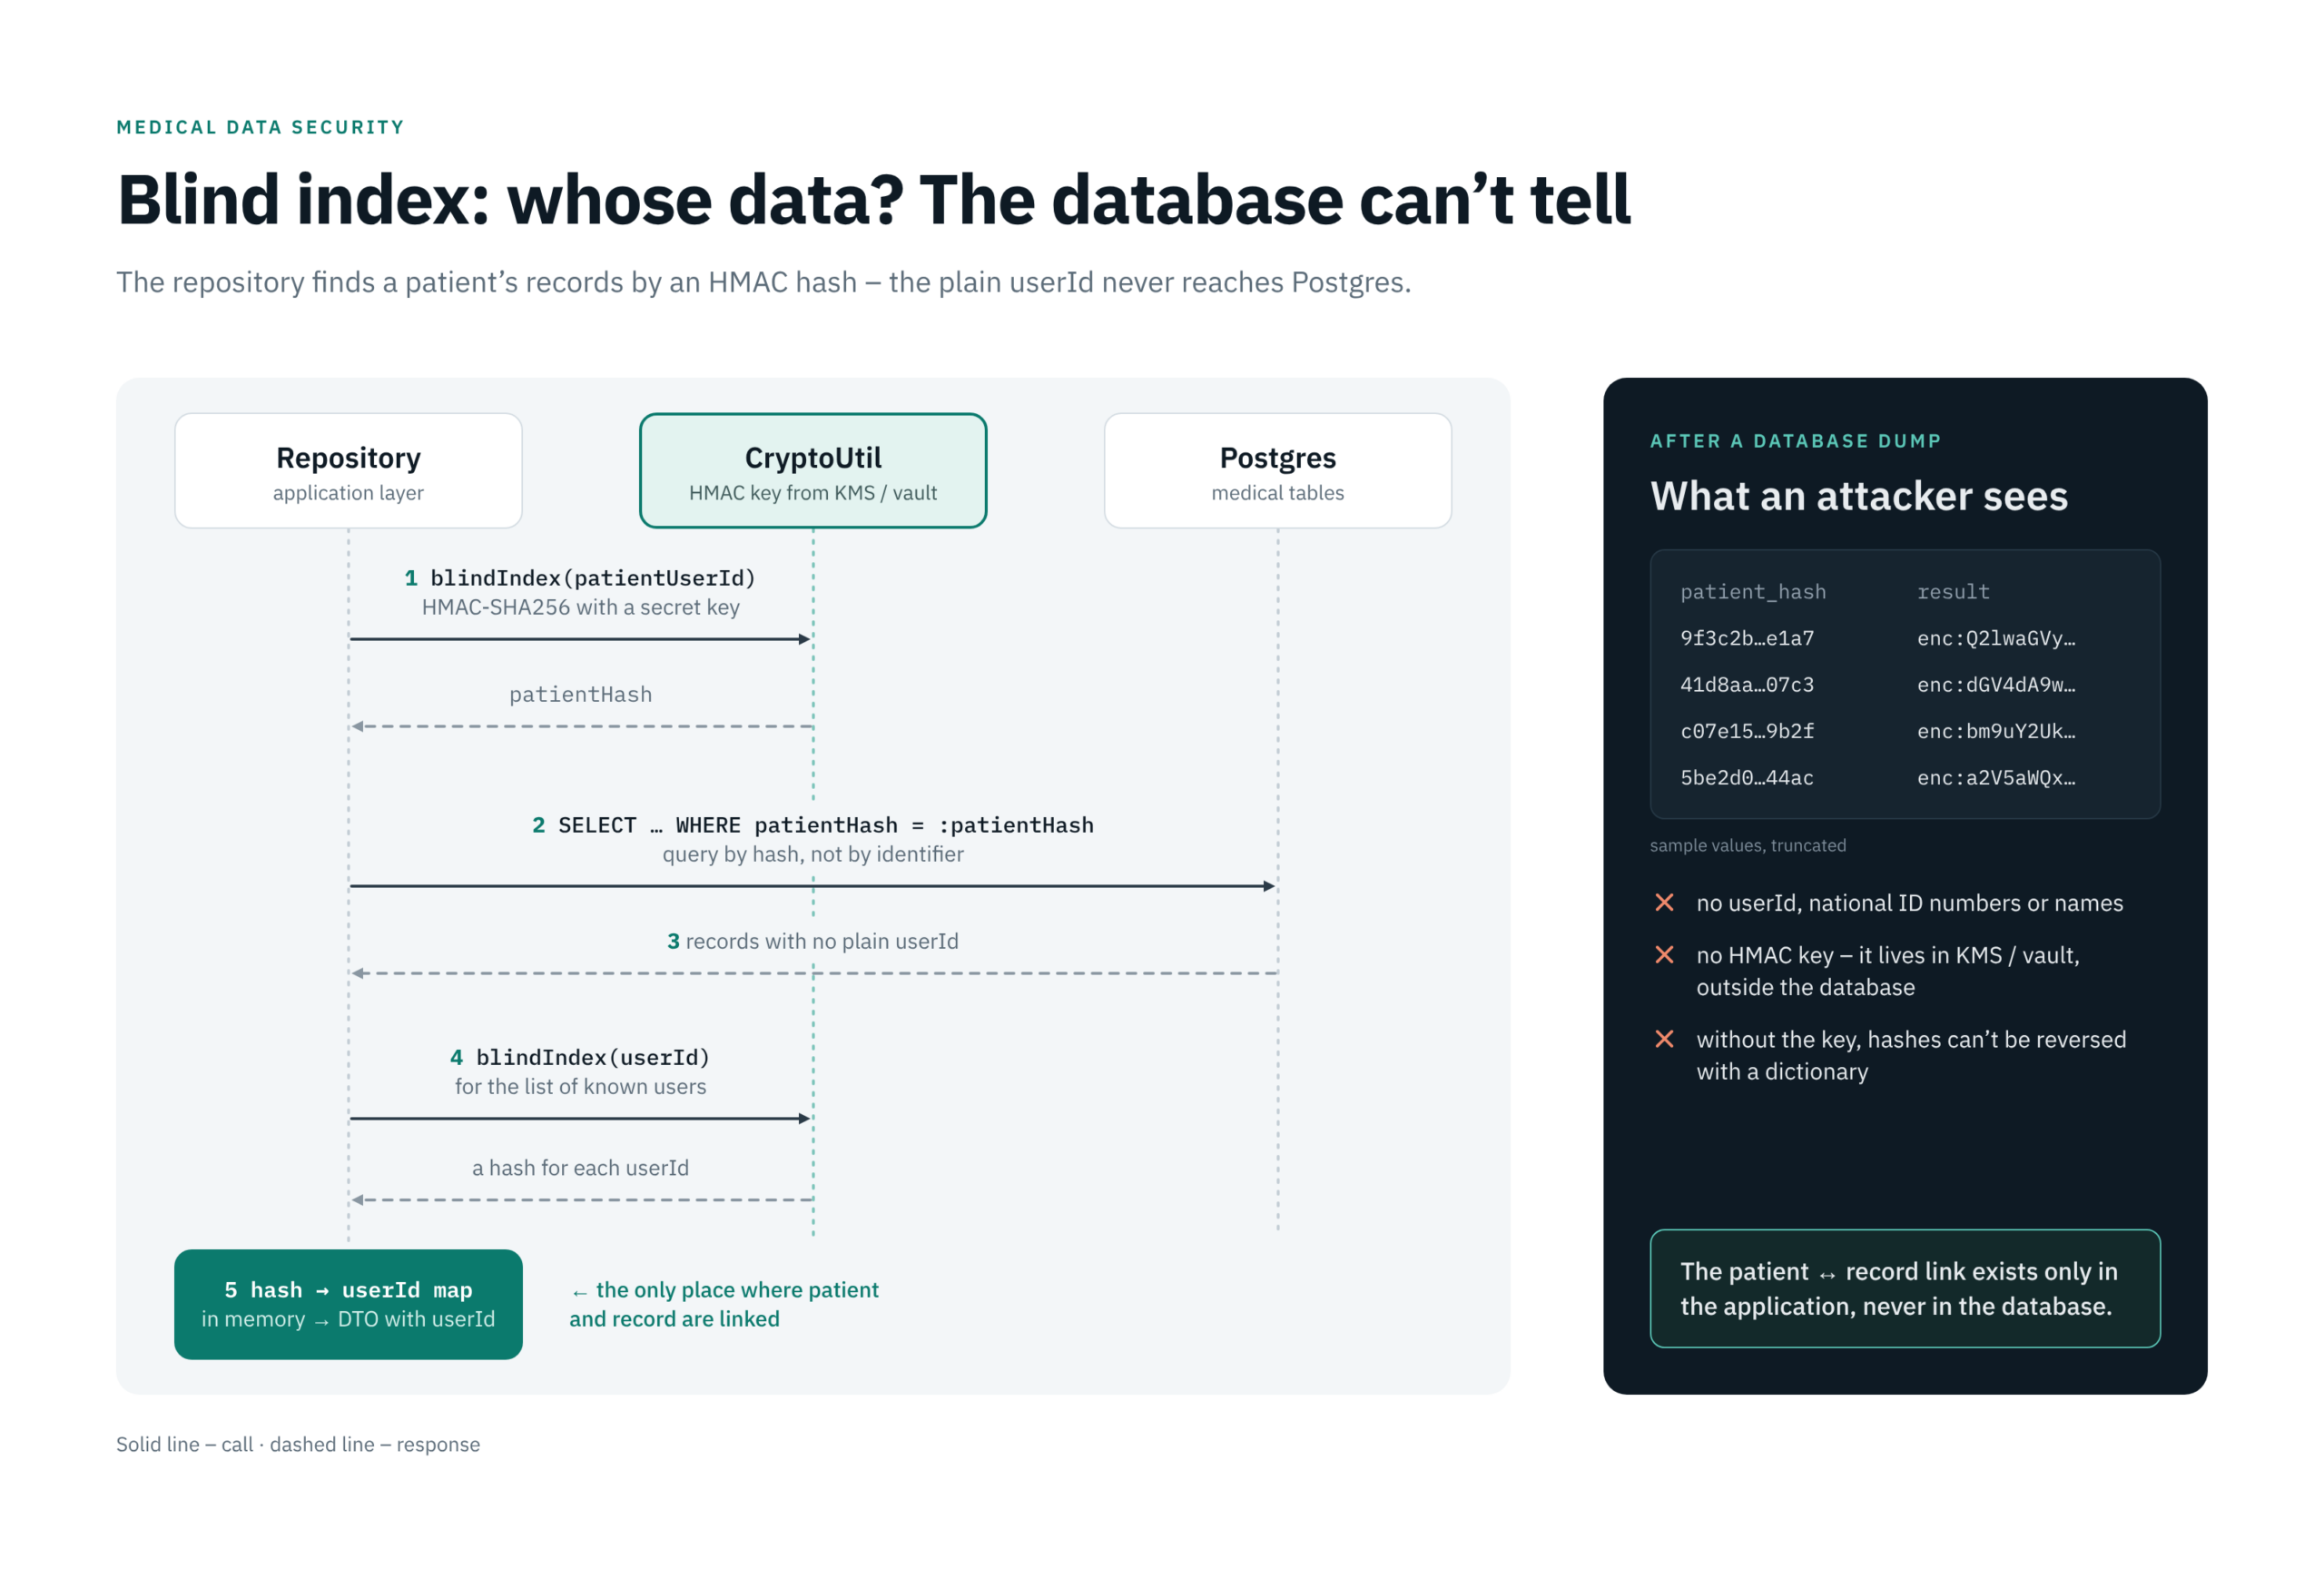
W tabelach medycznych nie trzymamy jawnego userId, tylko kolumnę patientHash z indeksem. Przepływ w repozytorium wygląda tak:
Na co uważać z technicznego punktu widzenia
- HMAC, nie goły SHA-256. Przestrzeń PESEL-i czy ID jest mała – zwykły hash da się odwrócić słownikiem w minuty. Bez klucza HMAC skrót jest bezużyteczny.
- Osobny klucz dla blind indexu i osobny do szyfrowania. Klucze w KMS / vault, nigdy w tej samej bazie.
- Normalizacja wejścia przed hashowaniem (wielkość liter, spacje), inaczej wyszukiwanie zacznie „gubić” rekordy.
- Ograniczenia: tylko równość (bez LIKE i zakresów), widoczne częstotliwości, a rotacja klucza oznacza przeliczenie indeksów – trzeba to zaplanować od początku.
- Efekt: zrzut tabeli medycznej to zbiór wyników badań i skrótów, których nie da się przypiąć do konkretnej osoby bez klucza z innej warstwy.
Rozdział danych medycznych od pozostałych
Drugi wzorzec to zasada, że dane medyczne nie żyją w jednym „worku” z resztą systemu. Rozdzielamy trzy warstwy:
Bazy danych
- Dane domenowe są oddzielone od logu dostępu do danych medycznych – to osobna baza.
- Log jest zapisywany poza transakcją operacji. Jeśli operacja się wycofa, ślad próby dostępu i tak zostaje – a to właśnie te ślady są potrzebne przy analizie incydentu.
- Osobne poświadczenia i osobne SSL dla każdej bazy. Przejęcie konta aplikacji domenowej nie daje możliwości odczytu ani „wyczyszczenia” logu audytowego (dobra praktyka: konto aplikacji ma do logu tylko prawo INSERT).
Przechowywanie plików
Katalog / przestrzeń public– tylko treści, które i tak są serwowane po URL (np. grafiki, materiały marketingowe).Katalog / przestrzeń private– wyłącznie szyfrogram, bez publicznego URL. Odczyt jest możliwy tylko przez przygotowaną metodę, która sprawdza uprawnienia, odszyfrowuje plik i zapisuje dostęp w logu.
Podsumowanie
Żaden z tych wzorców nie zatrzyma napastnika na wejściu – od tego są aktualizacje, segmentacja sieci, MFA i monitoring. Niezwykle ważna jest też edukacja Waszych pracowników i szkolenia z zakresu bezpieczeństwa. Wiele ataków udaje się nie przy użyciu wyrafinowanych narzędzi hakerskich, a dzięki prostym podstępom, phishingowi czy użyciu haseł z innych serwisów.
Jednakże zastosowanie technicznych środków ochrony danych zmienia to, co napastnik wynosi: zamiast gotowej kartoteki „PESEL + diagnoza” dostaje skróty bez klucza, szyfrogramy bez URL i log, którego nie mógł usunąć. W danych medycznych to różnica między incydentem a katastrofą dla milionów pacjentów.


